Welches Sprachmodell ist das richtige?
Diese Frage müssen Sie sich im HUB nicht mehr bei jeder Nachricht stellen. Aktivieren Sie das Feature bei Bedarf durch Anklicken von “Automatisches LLM” in der Sprachmodell-Auswahl. Der HUB entscheidet nun selbst, was zur jeweiligen Anfrage passt.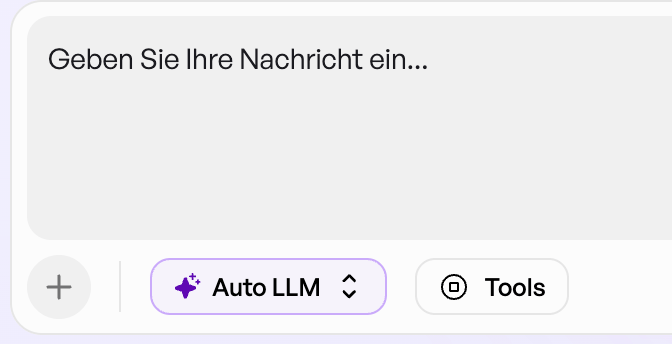
Effort – wie lange das Modell nachdenkt
Moderne Sprachmodelle können sich vor der Antwort unterschiedlich viel Zeit zum „Nachdenken” nehmen. Mehr Denkzeit bringt bei kniffligen Aufgaben bessere Ergebnisse – kostet aber Zeit und Rechenleistung. Damit einfache Anfragen nicht unnötig lange rechnen, können Sie diesen Aufwand jetzt direkt im Chat selbst einstellen. So funktioniert’s: Unterhalb des Eingabefelds finden Sie innerhalb der Modellauswahl den Schalter Effort. Ein Klick öffnet einen Regler zwischen „Niedrig” und „Hoch” – Sie verschieben ihn einfach in die gewünschte Richtung. Die Einstellung gilt sofort für Ihre nächste Nachricht.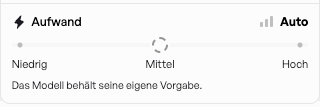
- Nach links (Niedrig): für kurze, klare Aufgaben – Umformulierungen, Übersetzungen, schnelle Nachfragen. Sie bekommen die Antwort spürbar schneller.
- Nach rechts (Hoch): für wirklich komplexe Aufgaben – mehrstufige Analysen, anspruchsvolle Berechnungen, kniffligen Code oder Aufgabenstellungen mit vielen Randbedingungen. Rechnen Sie hier mit längeren Antwortzeiten.
Freischaltung: Das Feature “Automatisches Modell-Routing” muss zunächst durch den Administrator Ihrer Organisation freigeschaltet werden. Die Freischaltung erfolgt unter Einstellungen → Feature Flags. Solange das Feature nicht aktiviert ist, wird es in der Navigation nicht angezeigt.