> ## Documentation Index
> Fetch the complete documentation index at: https://handbuch.neuland-hub.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# Product News (27.08.2026)
### **🧩Automatisierte Orchestrierung – Workflows entstehen im Gespräch (Beta)**
Bisher haben Sie den HUB pro Anfrage mit dem bereits etablierten Orchestrator neu instruiert. Der Orchestrator arbeitete dabei bisher im verborgenen.
Mit der **automatisierten** **Orchestrierung** heben Sie diese Funktion nun auf eine einsehbare und steuerbare Ebene. Sie definieren einen Ablauf in einem Chat-Dialog, können diesen danach anzeigen lassen und ihn danach beliebig oft laufen lassen – ohne Code, ohne Node-Editor, ohne Workflow-Baukasten.
Die Namensgebung kann sich dabei mit Abschluss der BETA-Phase ändern, die Funktionsweise bleibt aber bestehen:
**So funktioniert's:**
1. Sie beschreiben im Chat in normaler Alltagssprache, was passieren soll – z. B.: *„Hol dir jeden Montag alle offenen Jira-Issues aus dem Projekt HUB, fasse sie zusammen und schick mir das als strukturierte E-Mail."*
2. Der HUB stellt Ihnen **Rückfragen**, wo etwas unklar ist (welches Projekt, welcher Empfänger, welches Format), und erzeugt daraus einen Workflow.
3. Sobald der Chat Ihnen die Ergebnisse liefert, die Sie erwarten, können Sie den Ablauf hinter dem Chat als Orchestrierung erstellen lassen. Dafür klicken Sie oben im Chat auf "Create Orchestration" oder geben den entsprechenden Befehl direkt im Chat. Die Übertragung in einen Workflow kann dabei wenige bis mehrere Minuten dauern.
4. Der fertige Ablauf wird Ihnen **als Ablaufdiagramm angezeigt** – Sie sehen jeden Schritt, jede Bedingung und jedes verwendete Tool.
5. Der Workflow wird gespeichert und kann jederzeit erneut ausgeführt oder auch abgeändert werden werden. Gehen Sie dafür in den entsprechenden Chat oder in den Reiter Orchestration.
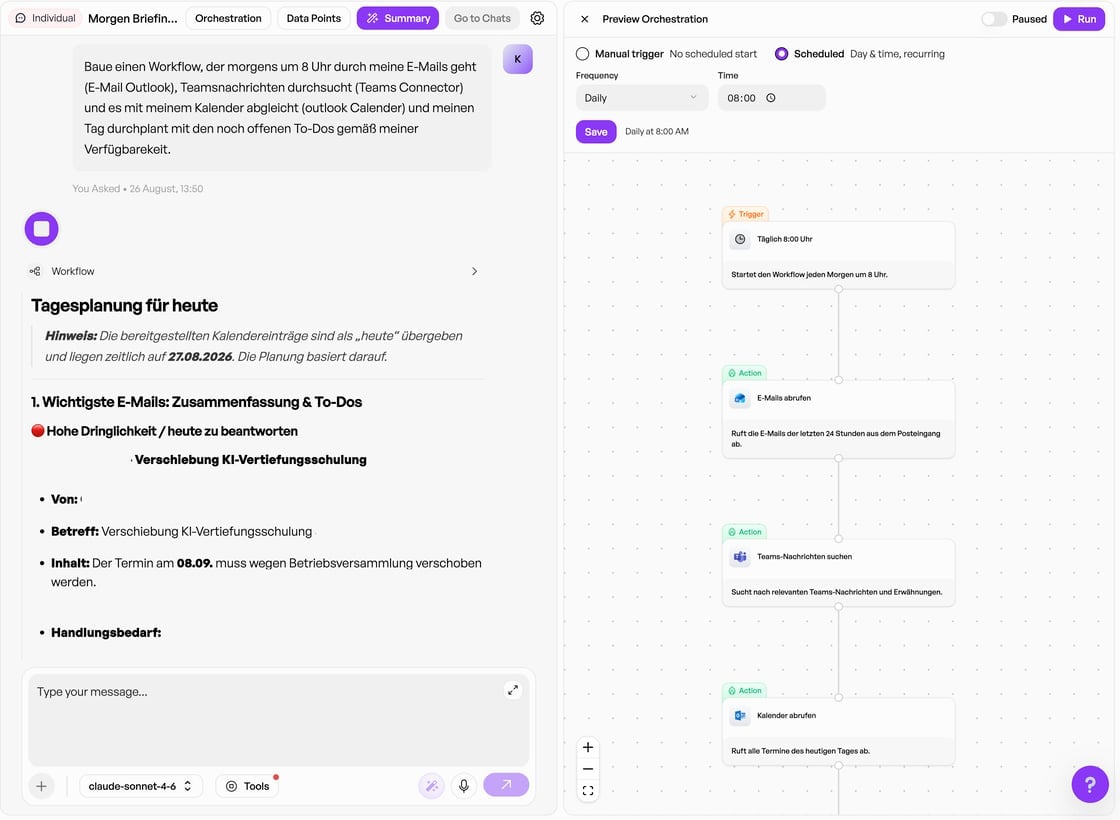 **Das Wichtigste zur Bedienung:** Sie bearbeiten die Schritte **nicht direkt im Diagramm**.
Änderungen beschreiben Sie wieder **im Chat** – z. B. *„Nimm den Schritt mit dem Excel-Export raus und schick stattdessen nur den Text"*. Der HUB baut den Workflow daraufhin um. Das ist bewusst so gestaltet: Sie sollen sich um das *Was* kümmern, nicht um das Verdrahten von Bausteinen.
**Was die Automatisierung kann:**
* **Alle Tools, die auch der Chat kann.** Was Ihre Nutzer heute im Chat per Konnektor erreichen, steht auch der Orchestrierung zur Verfügung – u. a. Jira, Confluence, HubSpot, Outlook (Mail & Kalender), Microsoft Teams, Fireflies, SQL-Datenbanken sowie die KI-Werkzeuge des HUBs wie Code & Data Analyst, Zusammenfassungen und Textentwürfe.
* **Nicht nur lineare Ketten.** Je nachdem, wie Sie den Ablauf beschreiben, entstehen einfache Abfolgen – oder Workflows mit Bedingungen („wenn kein Ergebnis, dann …") und **Schleifen**, etwa „gehe jeden Kontakt aus der Liste einzeln durch".
* **Deterministische Ausführung.** Die Schritte laufen als fest definierter Ablauf über die jeweiligen Schnittstellen. Nur dort, wo bewusst KI im Spiel ist (Texte formulieren, Inhalte zusammenfassen), entstehen variable Ergebnisse.
* **Verwaltung an einem Ort.** In der Orchestrierungs-Ansicht sehen Sie alle gespeicherten Workflows, können sie ansehen, anpassen, manuell starten und löschen. Bei jedem Lauf sehen Sie live, an welchem Schritt der HUB gerade arbeitet.
⚠️ **Bitte beachten Sie: Wir starten hier bewusst als Beta.** Die automatisierte Orchestrierung ist ein großer Schritt für die Plattform – und sie ist neu. Es kann in den ersten Wochen zu Fehlern kommen, insbesondere bei sehr komplexen Abläufen, beim gleichzeitigen Einsatz mehrerer Systeme in einem Schritt oder beim Versand an mehrere Empfänger. Das manuelle Nachschärfen einzelner Zweige sehr komplexer Workflows ist zum Start noch nicht möglich – hier hilft aktuell nur die Neubeschreibung im Chat.
Wir bitten Sie ausdrücklich um Feedback: Jede Fehlermeldung, die Sie uns über den Helpdesk ([support@neuland.ai](mailto:support@neuland.ai)) melden, hilft uns, die Orchestrierung schnell zu härten.
**Freischaltung:** Die Orchestrierung wird pro Organisation freigeschaltet und ist nicht per default verfügbar. Wenn Sie starten möchten, so stimmen Sie sich bitte mit Ihrer Organisation ab und wenden Sie sich bitte an [support@neuland.ai](mailto:support@neuland.ai)
***
### ⚡️Automatische Modellwahl (BETA) und Effort – passend statt kompliziert
Welches Sprachmodell ist das richtige? Und wie lange soll es nachdenken? Diese beiden Fragen müssen Sie sich im HUB nicht mehr bei jeder Nachricht stellen. Beide Schalter unterhalb des Eingabefelds stehen standardmäßig auf **Auto** – der HUB entscheidet selbst, was zur jeweiligen Anfrage passt.
#### 🤖 Automatische Modellwahl
Steht die Modellauswahl auf **Auto**, wird **jede einzelne Nachricht** je nach Komplexität an ein passendes Sprachmodell weitergereicht. Eine kurze Rückfrage landet bei einem schnellen Modell, eine anspruchsvolle Analyse bei einem leistungsstärkeren. Das geschieht innerhalb einer laufenden Unterhaltung – Sie müssen also nicht vorab abschätzen, wohin sich ein Gespräch entwickelt.
Dabei kommen ausschließlich die Modelle zum Einsatz, die **Ihnen** zur Verfügung stehen. Was Ihr Administrator über **Resource Access** nicht freigegeben hat, wird auch von der automatischen Wahl nicht verwendet.
Sie behalten selbstverständlich die Kontrolle: Über die Modellauswahl können Sie wie gewohnt jederzeit **manuell ein bestimmtes Modell festlegen** – etwa wenn Sie Ergebnisse vergleichen möchten oder für eine Aufgabe bewusst ein bestimmtes Modell bevorzugen.
#### 🎚️ Effort – wie lange das Modell nachdenkt
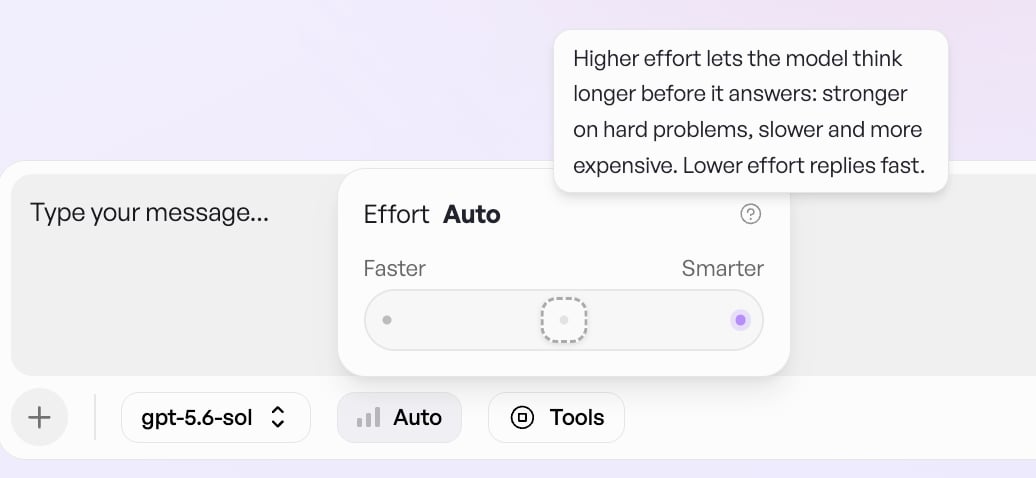 Moderne Sprachmodelle können sich vor der Antwort unterschiedlich viel Zeit zum „Nachdenken" nehmen. Mehr Denkzeit bringt bei kniffligen Aufgaben bessere Ergebnisse – kostet aber Zeit und Rechenleistung. Damit einfache Anfragen nicht unnötig lange rechnen, können Sie diesen Aufwand jetzt direkt im Chat selbst einstellen.
**So funktioniert's:**
Unterhalb des Eingabefelds finden Sie neben der Modellauswahl den Schalter **Effort**. Ein Klick öffnet einen Regler zwischen **„Faster"** und **„Smarter"** – Sie verschieben ihn einfach in die gewünschte Richtung. Die Einstellung gilt sofort für Ihre nächste Nachricht.
**Unsere Empfehlung:**
Die Voreinstellung liegt in der **Mitte** und ist für typische Aufgaben genau richtig – Zusammenfassen, Formulieren, Recherchieren, Fragen zu Dokumenten. In den allermeisten Fällen müssen Sie also gar nichts ändern.
* **Nach links (Faster):** für kurze, klare Aufgaben – Umformulierungen, Übersetzungen, schnelle Nachfragen. Sie bekommen die Antwort spürbar schneller.
* **Nach rechts (Smarter):** für wirklich komplexe Aufgaben – mehrstufige Analysen, anspruchsvolle Berechnungen, kniffligen Code oder Aufgabenstellungen mit vielen Randbedingungen. Rechnen Sie hier mit längeren Antwortzeiten.
> **Faustregel:** Drehen Sie den Regler erst dann hoch, wenn Sie mit dem Ergebnis der Standardeinstellung nicht zufrieden waren. Dauerhaft auf „Smarter" zu arbeiten, verlangsamt Ihre einfachen Anfragen unnötig und erhöht die Kosten, ohne dass das Ergebnis besser wird.
***
### 📎 Neu: Dateien direkt aus dem Chat via Mail versenden
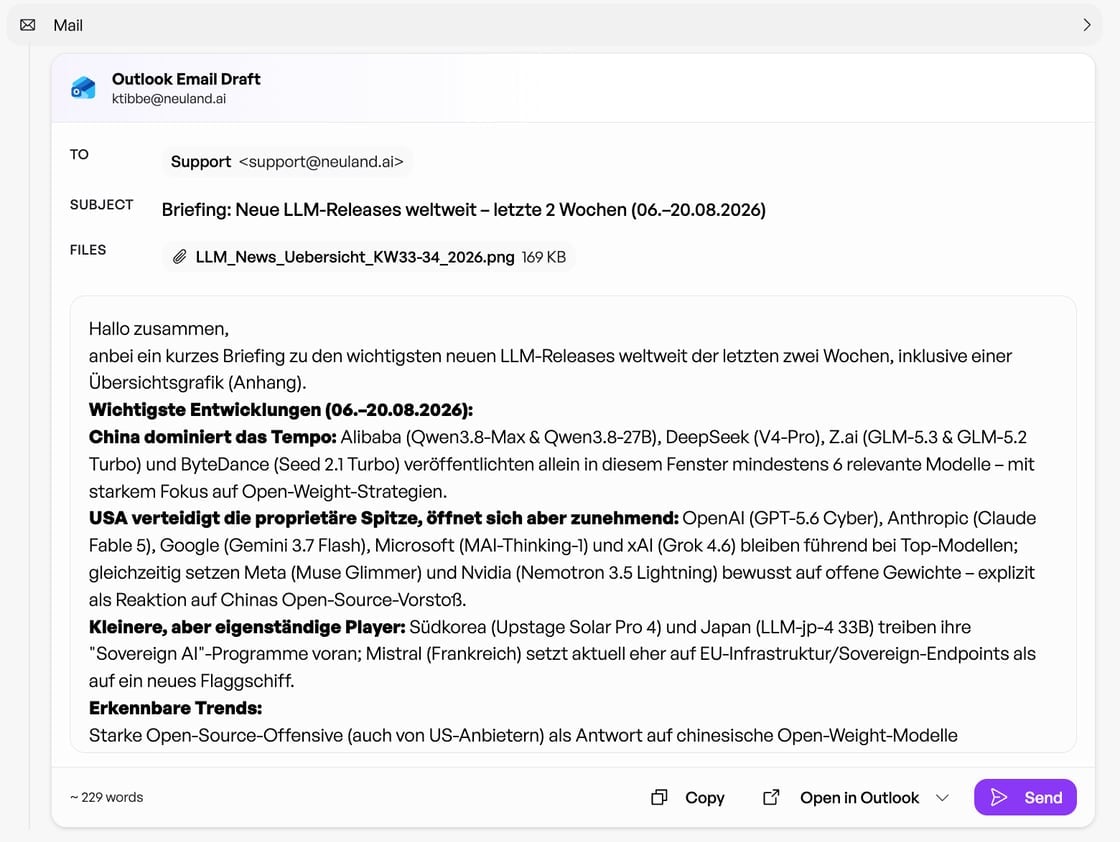 Bisher konnte der HUB über die Konnektoren Nachrichten und Mails schreiben – aber keine Dateien mitschicken. Das ändert sich: **Anhänge werden jetzt unterstützt** – zunächst für **Outlook (E-Mail)** und **Microsoft Teams**.
**So funktioniert's:**
* Laden Sie eine Datei wie gewohnt im Chat hoch – oder lassen Sie sich eine erzeugen (z. B. eine Excel-Auswertung durch den Code & Data Analyst).
* Bitten Sie den HUB, die Datei zu versenden, z. B. *„Schick diese Auswertung per Mail an das Team"*.
* Vor dem Versand sehen Sie den fertigen Entwurf inklusive Anhang und geben ihn frei – das Human-in-the-Loop-Prinzip greift auch hier.
**Gut zu wissen:**
* Standardgrenzen sind typischer Weise: **20 MB pro Datei, 25 MB pro Versand, maximal 10 Dateien. Dies kann sich jedoch in Ihrer Organisation unterscheiden.**
* Bei Microsoft Teams wird die Datei technisch bedingt über OneDrive/SharePoint bereitgestellt und in der Nachricht verlinkt.
* Für Ihre Nutzer kann beim ersten Versand eine **erneute Berechtigungsbestätigung** gegenüber Microsoft erforderlich sein.
Eine weitere Verbesserung ist hier ebenfalls, dass Mails nun auch die angezeigte Formatierung übernehmen, wenn diese über die entsprechende Auswahl im E-Mail Programm als Entwurf geöffnet werden.
***
### **🧰 Assistenten als Werkzeuge im Chat**
Ihre Assistenten sind ab sofort nicht mehr nur eigene Chats – sie lassen sich **als Werkzeug in einer laufenden Unterhaltung** aufrufen. Sie arbeiten also im normalen Chat weiter und ziehen den passenden Spezialisten gezielt hinzu, statt die Unterhaltung zu wechseln.
Typisches Beispiel: Sie recherchieren im Chat zu einem Vertragspartner und lassen mitten in der Unterhaltung Ihren NDA-Prüfassistenten das angehängte Dokument bewerten – Ergebnis und Kontext bleiben an einer Stelle.
**So funktioniert's:**
1. Öffnen Sie den Bereich **Assistants** und suchen Sie die Karte des gewünschten Assistenten.
2. Klicken Sie oben rechts auf der Karte auf die **drei Punkte (…)**.
3. Wählen Sie **„Make available as tool"**.
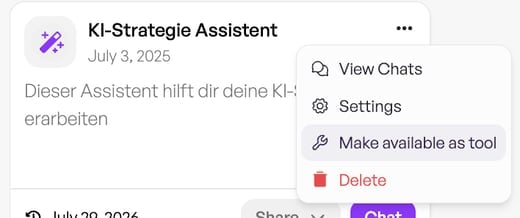
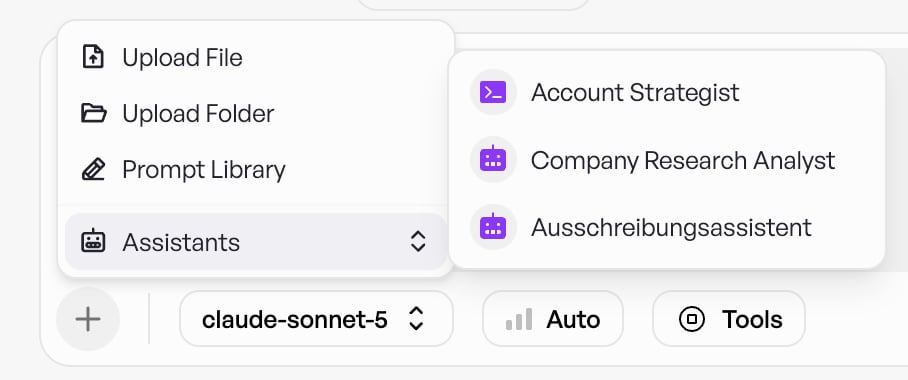 **Nach erfolgreicher Bereitstellung ist der Assistent für den geteilten Nutzer im Chat unter dem Plus-Zeichen verfügbar.**
**Wer den Assistenten als Werkzeug sieht:** Die Sichtbarkeit richtet sich nach der bestehenden Freigabe des Assistenten. Es sehen ihn also genau die Nutzer, mit denen Sie den Assistenten ohnehin geteilt haben – wer keinen Zugriff auf den Assistenten hat, bekommt ihn auch nicht als Werkzeug angeboten. Sie müssen die Berechtigungen also nicht doppelt pflegen.
> **Tipp:** Besonders sinnvoll ist das bei Assistenten mit einer klar umrissenen Aufgabe – Prüfen, Bewerten, Umformulieren, Recherchieren. Sehr breit angelegte Allrounder profitieren weniger davon, weil im Chat ohnehin dieselben Fähigkeiten zur Verfügung stehen.
***
### **📊 Verbrauch & Kosten im Blick – das neue Analytics-Dashboard**
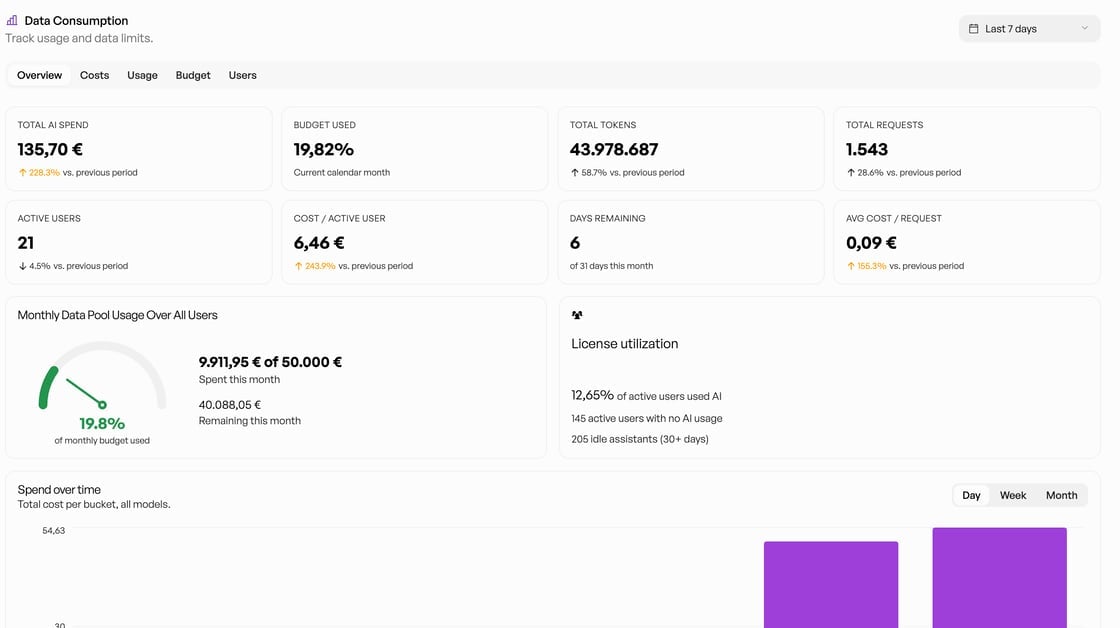 Das Verbrauchs-Reporting im HUB wird deutlich ausgebaut. Statt einer reinen Gesamtsumme erhalten Sie als Administrator eine differenzierte Auswertung:
* **Nutzung und Kosten nach Ebene**: Tenant, Nutzer, Gruppe, Assistent und API-Key.
* **Datei- und Speicherstatistiken** zu hochgeladenen Inhalten.
* **Rollenabhängige Ansichten** – wer welche Auswertung sehen darf, richtet sich nach den Berechtigungen.
* **Verbrauchsprognose**: Der HUB rechnet Ihren aktuellen Monatstrend hoch, damit Sie frühzeitig gegensteuern können.
Sie finden die Auswertungen unter **Einstellungen → Consumption**.
***
### **🔒 Resource Access – steuern, wer welche Modelle, Tools und Konnektoren nutzen darf**
Bisher galt: Was im HUB freigeschaltet war, stand allen Nutzern zur Verfügung. Mit **Resource Access** können Administratoren den Zugriff jetzt gezielt eingrenzen – auf einzelne Gruppen oder einzelne Personen.
Sie finden den Bereich in den **Administrator-Einstellungen in den Rollen.**
> **Wichtig:** Standardmäßig ist zunächst **alles für alle verfügbar**. Sie müssen also nichts tun, wenn Sie keine Einschränkung wünschen – der HUB verhält sich dann wie bisher. Erst wenn Sie einer Ressource gezielt Gruppen oder Nutzer zuweisen, greift die Beschränkung.
***
### **⚖️ Governance – zentrale Richtlinien für Ihren Tenant**
Bisher waren Aufbewahrungsregeln, KI-Vorgaben und Guardrails an unterschiedlichen Stellen verteilt. Mit dem neuen Bereich **Governance** steuern Administratoren diese Richtlinien gebündelt an einem Ort – gültig für die gesamte Organisation.
Sie finden ihn unter **Einstellungen → Governance**. Änderungen werden erst mit **„Save"** wirksam.
**Was Sie dort einstellen können:**
**Dokumenten-Aufbewahrung (Document retention):** Legen Sie fest, nach wie vielen Tagen nicht zugeordnete Dokumente automatisch gelöscht werden – voreingestellt sind 90 Tage. Wichtig: Dokumente, die einem Chat, einem Projekt oder einer Wissensbasis zugeordnet sind, bleiben unberührt. Betroffen sind ausschließlich verwaiste Uploads. Das hält Ihren Datenbestand schlank und unterstützt Ihre Löschkonzepte.
**E-Mail-Benachrichtigungen:** Sie entscheiden, worüber Administratoren automatisch informiert werden:
* **Budget alert emails** – Benachrichtigung, sobald eine Budgetschwelle überschritten wird.
* **Soft limit warning emails** – Benachrichtigung, sobald ein Nutzer sein weiches Ausgabelimit erreicht.
**Instruction Prompt:** Hinterlegen Sie eine übergreifende Vorgabe dafür, wie die KI in Ihrer Organisation antworten soll – etwa Tonalität (freundlich oder formell), eine fachliche Rolle oder eine bevorzugte Sprache. Diese Vorgabe wirkt tenant-weit und muss nicht mehr in jedem einzelnen Assistenten wiederholt werden.
**Guardrails:** Die Guardrails lassen sich zentral **aktivieren und deaktivieren**. Über die **Inbound Guardrails** beschreiben Sie in eigenen Worten, wie die KI mit eingehenden Anfragen umgehen soll – zum Beispiel, welche Themen sie zurückweisen oder mit einem Hinweis versehen soll. Da die Regeln in natürlicher Sprache formuliert werden, können Sie sie exakt auf Ihre Compliance-Anforderungen zuschneiden.
> **Unsere Empfehlung:** Testen Sie neue Guardrail-Regeln zunächst mit typischen Formulierungen aus Ihrem Arbeitsalltag, bevor Sie sie organisationsweit aktivieren. So stellen Sie sicher, dass legitime Anfragen nicht versehentlich blockiert werden.
***
### **🚀 Spürbare Verbesserungen im Alltag**
Neben den neuen Funktionen sind in diesem Sprint – inklusive eines zwischenzeitlichen Hotfixes – über 30 Fehlerbehebungen eingeflossen. Die wichtigsten im Überblick:
**Stabiler im Chat.** Der Chat blieb in bestimmten Situationen mit endlosem Ladeindikator stehen, brach mit sporadischen Fehlermeldungen ab oder reagierte nach langen Ladezeiten gar nicht mehr – all das ist behoben. Auch der „Weiter"-Button bei sehr langen, abgeschnittenen Antworten funktioniert wieder zuverlässig. Die Guardrails haben Unterhaltungen bisher zu häufig und mit unklarer Begründung blockiert; Erkennung und Meldungstext wurden überarbeitet. Dazu kommen kleinere Korrekturen an Codeblöcken, Tabellendarstellung und Spracheingabe.
**Verlässlicher bei Assistenten und Modellen.** Assistenten starteten beim Erreichen des Ausgabelimits neu oder blieben ohne Fehlermeldung endlos hängen – beides ist gelöst. Fällt ein Modell aus, greift jetzt zuverlässig ein Ersatzmodell, und Sie werden darüber informiert. Zusätzlich zeigen die Assistenten-Einstellungen wieder das tatsächlich verwendete Modell an, und der Code & Data Analyst hängt keine Rohausgaben mehr an seine Zusammenfassungen.
**Reibungsloser bei Anmeldung und Konnektoren.** Mehrere Anmeldeprobleme – etwa „E-Mail nicht gefunden" trotz gültigem Konto, fehlgeschlagene Logins bei externen Adressen und fehlerhafte SSO-Konfigurationen einzelner Tenants – sind behoben. Auf Konnektor-Seite lassen sich Confluence und Fireflies wieder problemlos verbinden, und Fehler bei der Autorisierung einzelner Integrationen gehören der Vergangenheit an.